O limite de ~120 resultados do Google Maps e como a grade quadtree o supera
Toda consulta do Google Maps retorna no máximo ~120 lugares. Veja a matemática da busca em grade quadtree (células de 3 km, subdivisão até profundidade 4) para cobrir 100% da região.
Qual é exatamente o limite de resultados do Google Maps?
Resposta direta: aproximadamente 120 lugares por consulta — historicamente 60 com paginação por rolagem, hoje consolidado no máximo que a UI carrega. O número exato oscila entre versões, mas a ordem de grandeza não.
Para uma categoria popular em uma metrópole (ex.: 'clínicas odontológicas' em São Paulo, com dezenas de milhares de estabelecimentos), 120 resultados representam menos de 1% do mercado. É por isso que duas pessoas buscando a mesma coisa veem resultados diferentes: ambas veem amostras truncadas.
Definição citável: o teto de ~120 resultados é uma restrição de paginação da interface do Google Maps por consulta — a única forma de contorná-lo sem API é particionar a busca espacialmente.
Como funciona a busca em grade quadtree (passo a passo)?
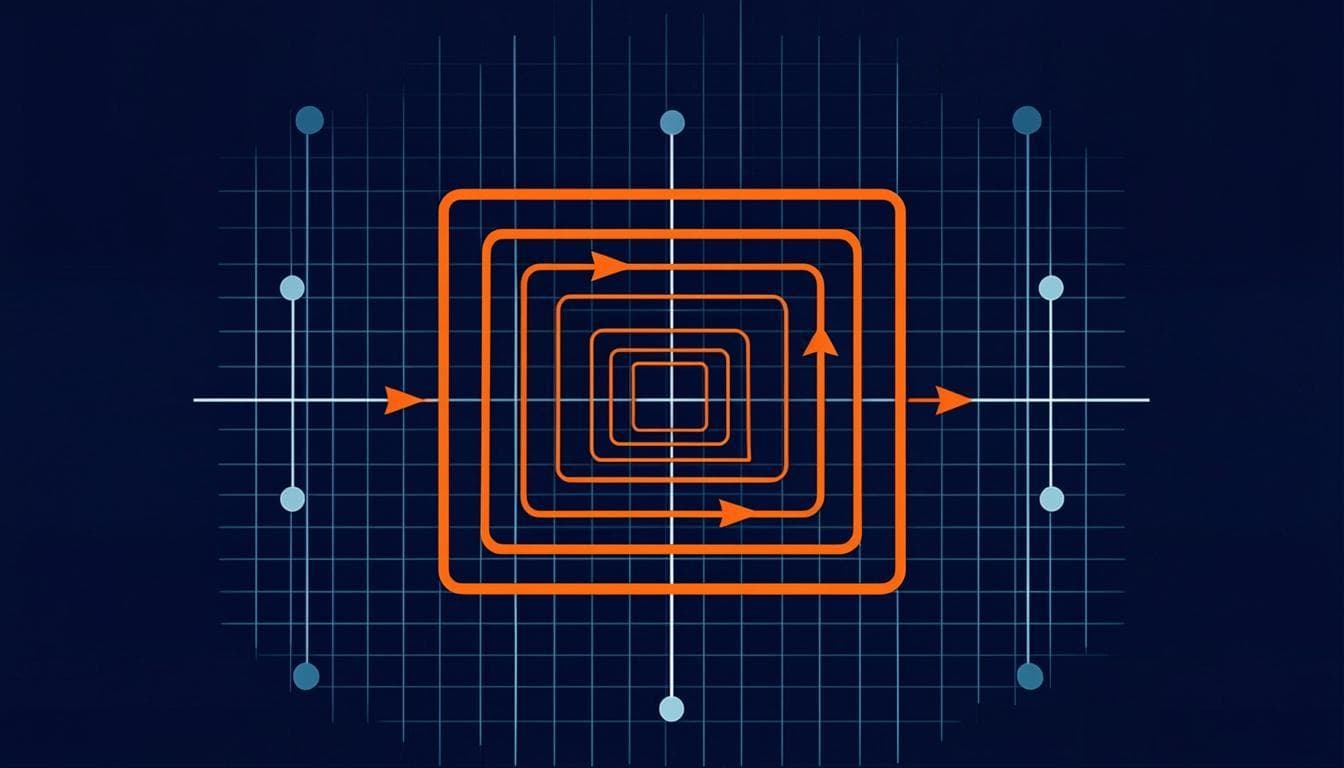
Resposta direta: a quadtree divide recursivamente o espaço 2D em 4 quadrantes; cada célula é pesquisada de forma independente e só é subdividida quando atinge o limite de resultados — o que concentra o esforço exatamente nas áreas densas.
- Obtenha a bounding-box da área: desenho no mapa, CEP/endereço geocodificado (OpenStreetMap/Nominatim, sem custo) ou centro + raio.
- Gere a grade inicial com células de ~3 km (área urbana média: dezenas de células; metrópole: centenas).
- Para cada célula, navegue para /maps/search/<termo>/@LAT,LNG,15z e aguarde a carga completa com scroll humanizado.
- Extraia os lugares da célula com a cascata payload → DOM → detalhe.
- Se a célula devolveu ≥ 100 resultados, assuma truncamento: divida em 4 subcélulas (quadtree) e enfileire as sub-buscas.
- Repita até profundidade 4 ou até células esgotadas (< 100 resultados = área coberta).
- Deduque por place_id + CID a cada inserção — sobreposição de bordas entre células é inevitável.
| Profundidade | Tamanho da célula | Risco de truncamento | Uso típico |
|---|---|---|---|
| 0 | Cidade inteira | Altíssimo (sempre > 120) | Maior cidade do interior |
| 1 | ~6 km | Alto em categorias populares | Bairros afastados |
| 2 | ~3 km | Médio (subdivide em centros) | Cobertura urbana padrão |
| 3 | ~1,5 km | Baixo | Centros densos (centro, avenidas) |
| 4 | ~750 m | Praticamente nulo | Regiões hiperdensas (ex.: Paulista) |
Por que persistir as células (e não só os leads)?
Resposta direta: porque buscas reais são interrompidas — o notebook fecha, a rede cai, o operador pausa. Sem persistência de células, você recomeça do zero e queima sessões repetindo trabalho.
No Play Google Scraper cada célula guarda status (pendente, em andamento, concluída, subdividida, cancelada), profundidade, contagem de resultados e relação com a busca pai. O progresso mostrado no painel é literal: células concluídas ÷ células totais, com ETA calculada pelo ritmo médio por célula. Ao retomar, a fila começa exatamente na célula onde parou.
Quanto tempo leva uma busca em grade completa?
Resposta direta: depende do número de células e do perfil de humanização. Com o perfil Moderado (~700 lugares/h) uma cidade média com 40 células esgotadas em ~25–35 min; uma metrópole com 400 células e subdivisões roda em lotes ao longo de horas com o circuit breaker protegendo a sessão.
A aritmética honesta: cada célula custa ~10–25s de navegação e extração. Perfis mais rápidos existem (Turbo, ~4.000 lugares/h), mas o ganho real de cobertura vem da grade — velocidade alta sem grade só chega ao mesmo teto de 120, mais rápido.
Perguntas frequentes
Fontes e referências
Este artigo está disponível em português (pt-BR). · Play Google Scraper